

本文探讨了使用Brotli压缩后百度搜索引擎抓取数据出现的问题。作者发现,尽管Brotli压缩能提高页面加载速度,但由于百度爬虫的解析服务不支持Brotli编码,导致页面内容在抓取时变成乱码或空内容,进而影响网站收录。作者通过分析Nginx配置、爬虫请求头以及CDN缓存问题,揭示了这一现象背后的原因,并提出了解决方案。
做网站性能调优的时候,几乎所有人都会盯着 Google Lighthouse 和 Core Web Vitals 的报告看。看到诊断建议里跳出一条“启用文本压缩”,很多人顺手就去给 Nginx 编译了 Google 的 ngx_brotli 模块。
Brotli 的压缩比确实比老旧的 gzip 高出一截。同样的 HTML 和 JS 脚本,gzip 压完还能剩 30% 体积,Brotli 直接能给按到 20% 出头。现代浏览器早就全线支持 br 编码,PageSpeed 分数刷刷往上涨,网络传输耗时明显下降。
可把全站 Brotli 跑了差不多两周后,我登录百度搜索资源平台看数据,当场倒吸了一口凉气。
抓取频次曲线直接腰斩,抓取异常监控里密密麻麻全是红色报警。点开几百条失败详情,报错原因非常统一:不是“页面内容为空”,就是“编码解析异常”。更致命的是,站点的收录索引量开始断崖式下跌,新发的内容连续几天完全不抓。
我用 Chrome 访问页面,检查 DevTools 里的 Network 面板,HTTP 状态码是清清楚楚的 200,响应头里带着 content-encoding: br,内容渲染毫无问题。既然浏览器看一切正常,为什么百度的爬虫抓回去会变成空内容甚至乱码?
折腾了整整一个周末,我把整个请求链条从爬虫特征、Nginx 协商逻辑到 CDN 缓存规则逐层扒开,找到了几个藏得极深的坑。
以为蜘蛛和浏览器一样聪明:Baiduspider 对 br 编码的诡异支持
很多人理所当然地认为,HTTP 客户端和服务器之间是靠 Accept-Encoding 请求头自适应协商的。客户端能解压什么就报什么,服务器按客户端的能力返回对应的 Content-Encoding,怎么可能会乱码?
现实情况远比协议规范骨感得多。
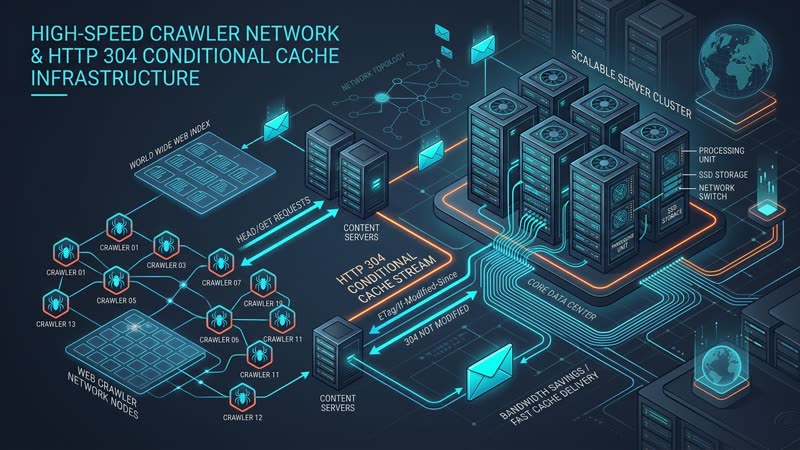
我翻出 Nginx 的 access.log,拉出几条百度蜘蛛的抓取记录,发现了第一种离谱的场景。百度蜘蛛发过来的请求头里,有的节点确实只带了 gzip:
GET /posts/nginx-performance-tuning.html HTTP/1.1
Host: www.example.com
User-Agent: Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)
Accept-Encoding: gzip, deflate
Accept: */*
如果这时候 Nginx 正确配了 gzip 和 brotli 的优先级,返回 gzip 倒也没事。
致命的是第二种场景。百度在不同机房部署的爬虫节点版本千差万别,我抓包抓到了好几批来自百度蜘蛛的请求,请求头里赫然写着:
Accept-Encoding: gzip, deflate, br爬虫既然声明了支持 br,Nginx 默认优先选择压缩比更高的 Brotli 算法,于是理所当然地返回了:
HTTP/1.1 200 OK
Content-Type: text/html; charset=UTF-8
Content-Encoding: br
Vary: Accept-Encoding
问题恰恰出在这里。百度的网络抓取组件可能升级了底层的 libcurl 或者网络请求库,请求头自动带上了 br 标头,但是它后端负责页面解析、正文提取和索引入库的分析服务,根本没有内置 Brotli 解压逻辑,依然固执地把响应体当成 gzip 或者纯文本解压。
解压失败的结果很直接:解析模块拿到的是一段乱码二进制,字符集匹配完全错乱,直接判定为空页面或者乱码页面。既然是垃圾内容,搜索引擎自然不会建立索引,甚至会把原本已有的收录当作失效死链处理。
我们可以用 curl 模拟带 br 的请求,看看原始返回:
curl -s -H "User-Agent: Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)" \
     -H "Accept-Encoding: gzip, deflate, br" \
     https://www.example.com/posts/nginx-performance-tuning.html | head -c 100 | xxd
终端打印出来的全是不可读的十六进制字节。浏览器内核知道怎么解码,百度的索引入库流程却在这里翻了车。
CDN 边缘缓存的背刺:Vary 标头丢失与强制转码
除了爬虫自身的兼容问题,套在服务器前面的 CDN 是第二个重灾区。
为了分担源站压力,很多站长会在 CDN 控制台里打开诸如“智能压缩”或者“Brotli 自动压缩”的开关。这个开关一旦打开,哪怕你的源站给爬虫老老实实吐的是 gzip,CDN 边缘节点也可能自作聪明地在回源后把 gzip 解开,重新压缩成 Brotli 存进边缘缓存。
更常见的灾难是缓存污染。当真实用户用 Chrome 浏览器第一次访问某个页面时,CDN 节点向源站请求该页面,源站返回了 Brotli 压缩后的内容。如果源站或者 CDN 没有严格处理 Vary: Accept-Encoding,CDN 就会把这份 br 编码的数据缓存起来。
五分钟后,一只只声明了 Accept-Encoding: gzip 的百度蜘蛛打到同一个 CDN 边缘节点。因为缺少正确的 Vary 隔离,CDN 命中了刚才为 Chrome 缓存的 br 资源,看都不看就直接吐给了爬虫。
爬虫只想要 gzip,服务器却塞给它一个 br,或者直接返回没有 Content-Encoding 标识的压缩二进制,抓取异常当场爆发。
排查这个问题时,可以直接向 CDN 节点发请求验证:
curl -i -H "User-Agent: Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)" \
     -H "Accept-Encoding: gzip, deflate" \
     https://www.example.com/posts/nginx-performance-tuning.html
仔细核对返回的 HTTP 响应头:如果请求头只写了 Accept-Encoding: gzip,但响应头里居然出现了 Content-Encoding: br,或者没有 Content-Encoding 却带着乱码正文,那就说明 CDN 缓存层已经彻底乱套了。
静态预压缩文件的回退陷阱:brotli_static 与 gzip_static
为了榨干服务器 CPU,我一般不用 Nginx 实时动态压缩 HTML 和静态资源,而是在构建流程里用打包工具提前生成预压缩文件。
比如在 Vite 或者 Webpack 构建产物目录里:
dist/
├── assets/
│   ├── index.js
│   ├── index.js.br
│   └── index.js.gz
Nginx 提供了 brotli_static on; 和 gzip_static on; 两个指令。静态模块的逻辑是直接在磁盘上找对应的后缀文件,省去每次请求实时消耗 CPU 压缩的算力。
这里藏着一个极易被忽略的逻辑顺序坑:
如果构建脚本由于配置疏漏,只生成了 .br 文件,漏掉了 .gz 文件;或者某些动态生成的静态 HTML 缓存只有 .br。当不支持 Brotli 的爬虫发起请求时,Nginx 发现客户端不支持 br,于是去检查有没有 .gz。
发现磁盘上没有 .gz,而你为了省资源把动态 gzip on; 关掉了,Nginx 就会直接读取未压缩的原始原始大文件,甚至在某些强制静态匹配的特定规则下报 406。
更棘手的是优先级问题。在同时开启 brotli_static 和 gzip_static 的 location 块里,如果客户端同时声称支持两者,Nginx 会优先命中 .br。这本该是好事,但结合前文提到的百度蜘蛛伪支持 br 的情况,预压缩的 .br 文件就会被毫无保留地直接塞给蜘蛛。
必须确保两条铁律:
第一,所有预压缩流程必须同时产出 .br 和 .gz 两个版本,大小并存;
第二,必须在源站 Nginx 这一层,对所有已知的搜索引擎爬虫把 br 的能力彻底剥离掉。
Nginx 实战配置:通过 map 识别蜘蛛并优雅降级为 gzip
既然不能指望百度、搜狗这些老爬虫快速修好解压解析模块,我们只能在服务器端做主动防御。
思路非常明确:
针对普通真实用户的现代浏览器,继续全力输出 Brotli 压缩,享受极速首屏体验;
一旦识别到是国内搜索引擎爬虫,不管它的请求头里有没有带 br,一律强制禁用 Brotli,老老实实回退给它最古老但绝对不会出错的 gzip。
要实现这个逻辑,最干净的方案是在 Nginx 的 http 块里用 map 指令把爬虫特征过滤出来。
打开 /etc/nginx/nginx.conf 或者站点的 conf 配置文件:
http {
    # 针对搜索引擎蜘蛛的用户代理做正则匹配
    map $http_user_agent $is_spider {
        default 0;
        ~*(Baiduspider|Sogou|360Spider|YisouSpider|Bytespider|Bingbot|Googlebot) 1;
    }

    # 如果是蜘蛛,强制清空 brotli 支持标志
    map $is_spider $brotli_switch {
        1       off;
        default on;
    }

    server {
        listen 443 ssl http2;
        server_name www.example.com;

        # 基础压缩全局开启
        gzip on;
        gzip_min_length 1024;
        gzip_comp_level 6;
        gzip_types text/plain text/css application/json application/javascript text/xml application/xml application/xml+rss text/javascript image/svg+xml;
        gzip_static on;

        # Brotli 配置,动态继承上面的 switch 变量
        brotli $brotli_switch;
        brotli_comp_level 6;
        brotli_types text/plain text/css application/json application/javascript text/xml application/xml application/xml+rss text/javascript image/svg+xml;
        brotli_static on;

        # 确保关键响应头包含 Vary
        gzip_vary on;
        add_header Vary "Accept-Encoding, User-Agent" always;

        location / {
            try_files $uri $uri/ /index.php?$query_string;
        }
    }
}
注意看上面的核心技巧:
brotli 指令本身可以接收变量。当 $is_spider 匹配到 Baiduspider 或者 Bytespider 等蜘蛛标识时,$brotli_switch 计算为 off。此时对当前请求,Brotli 压缩引擎被物理关闭。
因为客户端请求头里通常依然带着 Accept-Encoding: gzip,Nginx 就会自然顺畅地回退到 gzip 压缩通道,吐出标准的 gzip 数据包。
最后那一项 add_header Vary "Accept-Encoding, User-Agent" always; 是给前面所有的 CDN 和代理节点立规矩:必须同时根据客户端的压缩支持能力和 User-Agent 分别做缓存隔离,彻底杜绝不同客户端之间的缓存内容串包。
配置生效验证与线上排查
配完之后检查语法并重新加载配置:
nginx -t
nginx -s reload
先用模拟普通浏览器请求测试,验证 Brotli 是否依然生效:
curl -I -H "User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36" \
     -H "Accept-Encoding: gzip, deflate, br" \
     https://www.example.com/posts/nginx-performance-tuning.html
输出头信息中应该看到:
content-encoding: br
vary: Accept-Encoding, User-Agent
接着模拟百度蜘蛛发起请求,同样带着 br 支持:
curl -I -H "User-Agent: Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)" \
     -H "Accept-Encoding: gzip, deflate, br" \
     https://www.example.com/posts/nginx-performance-tuning.html
此时的返回结果应该发生关键变化:
content-encoding: gzip
vary: Accept-Encoding, User-Agent
无论百度蜘蛛发什么 Accept-Encoding,服务器给它送出的都是稳稳当当的 gzip。
随后我盯了三天的 Nginx 访问日志。为了方便监控,我在 log_format 里追加了 $sent_http_content_encoding 变量:
tail -f /var/log/nginx/access.log | grep -E "Baiduspider|Bytespider"日志里刷出来的所有蜘蛛记录,状态码全部稳定在 200,对应的 Content-Encoding 清一色是 gzip。
一周之后,百度资源平台的抓取异常曲线直接归零,之前跌掉的收录页面开始逐渐重新放出。做技术运维和 SEO 调优,最怕的就是盲目追求跑分数字而忽视了生态各方的向下兼容性。工具和算法再先进,要是爬虫看不懂,跑出来的满分也没什么意义。
文章标题:网站开了 Brotli 压缩百度收录却断崖暴跌?排查 Baiduspider 压缩协议兼容、Nginx 动静态降级与 Content-Encoding 抓取乱码我踩过的几个坑
文章链接:https://llbbs.cn/jishujaocheng/243.html
本站文章均为原创,未经授权请勿用于任何商业用途
评论一下?