

网站升级至IPv6后,搜索引擎收录暴跌,原因在于Nginx未监听IPv6地址和爬虫对IPv6连接超时。解决方法包括检查Nginx配置确保监听IPv6,以及优化爬虫设置。
前阵子我给手头几个业务站做网络升级,云厂商后台刚好推出了免费的 IPv6 双栈支持。想着现在各大运营商都在推进 IPv6,搜索引擎也提倡双栈互通,我便在云服务器上分配了 IPv6 地址,顺手在域名解析平台加了一条 AAAA 记录。
解析生效后,我用手机 5G 和本地宽带的 Chrome 测试打开网站,加载速度飞快,DNS 检查也是双栈全绿。当时觉得这次升级顺风顺水,便没再多管。
直到两周后例行核对搜索引擎控制台,情况急转直下。Google Search Console 的“网页抓取统计信息”里,主机连接失败率从原本的 0% 直接飙升到了 38%,大量新发页面的状态变成了“已发现 - 目前未编入索引”;百度搜索资源平台的抓取频次曲线同样掉了一大截,点开抓取诊断测试,十次里有四次直接报“连接超时”或“无法连接主机”。
用普通浏览器打开明明毫无卡顿,为什么搜索引擎蜘蛛抓取时却像撞了南墙?我顺着网络链路一路抓包排查,才发现自己踩进了一个典型的双栈网络陷阱。
为什么普通用户能正常访问,爬虫却大面积超时?
很多站长遇到这种情况第一反应是域名被搜索引擎惩罚了,或者误以为爬虫节点抽风。其实问题出在现代桌面浏览器与搜索引擎抓取调度器在底层网络行为上的巨大差异。
现代主流浏览器(Chrome、Edge、Safari 等)早已普遍实现并启用了 Happy Eyeballs 算法(RFC 8305,双栈网络快速回退机制)。当浏览器发起 HTTP 请求时,它会向本地 DNS 同时查询 A 记录(IPv4)和 AAAA 记录(IPv6)。
浏览器拿到两个地址后,会优先尝试向 IPv6 地址建立 TCP 连接,但内部设有一个极短的倒计时定时器(通常只有 150ms 到 250ms)。如果 IPv6 在这短短两百毫秒内没有完成三次握手,或者直接被防火墙静默丢包,浏览器会立刻并行启动 IPv4 连接,谁先连通就走谁。
整个切换过程在后台无声无息地完成,人类在肉眼上几乎感觉不到两百毫秒的延迟抖动,理所当然地以为 IPv6 通信一切正常。
搜索引擎爬虫(尤其是 Googlebot 和部分具备 IPv6 抓取能力的百度集群)完全是另一套逻辑。
爬虫为了提高集群抓取吞吐量,底层调度通常跑在经过定制优化的网络客户端或异步抓取池中。以 Googlebot 为例,Google 官方明确说明,当目标域名发布了合法的 AAAA 解析记录时,Googlebot 会优先使用 IPv6 进行网络寻址。
更要命的是,爬虫节点并不像桌面浏览器那样具备几百毫秒就静默回退到 IPv4 的宽容策略。很多爬虫客户端会坚持等待 IPv6 的 TCP SYN 握手完成,直到触发系统层面的 Socket 连接超时(往往是 10 秒到 30 秒)。
当一个爬虫线程连卡几十秒最终超时断开,调度系统就会记上一笔“服务器不可达”。一旦这种超时占比上升,搜索引擎算法会迅速判定该站点网络基础设施不稳定,随之而来的就是调低抓取预算、延迟收录,甚至将原本已收录的 URL 标记为死链降权。
坑一:DNS 配了 AAAA,Nginx 虚拟主机却只监听了 IPv4
这是最常见也最隐蔽的基础配置疏漏。
很多人的 Nginx 配置文件是多年前写好的模板,或者使用一些轻量面板一键生成的。在站点配置块里,通常只写了这两行:
server {
    listen 80;
    listen 443 ssl http2;
    server_name example.com www.example.com;
    ...
}
在标准的 Linux 环境下,listen 80; 默认只绑定了 IPv4 通配地址 0.0.0.0:80,listen 443; 也同样只绑定了 0.0.0.0:443。
如果你在域名解析后台添加了解析到服务器 IPv6 地址的 AAAA 记录,DNS 服务器会诚实地将这个 IPv6 地址派发给所有发起查询的客户端。Googlebot 拿到 IPv6 之后,向该地址的 443 端口发送 TCP SYN 握手请求。
此时服务器内核的 TCP 协议栈收到包,翻查本地监听表,发现 443 端口根本没有进程监听 IPv6 地址,内核会根据系统配置直接回复一个 TCP RST(连接被拒绝),或者干脆超时。
排查这个问题很简单,直接在服务器终端执行网络监听查询:
netstat -tlpn | grep -E ':80|:443'如果输出结果里只看到类似这样的行:
tcp        0      0 0.0.0.0:80              0.0.0.0:*               LISTEN      1234/nginx: master
tcp        0      0 0.0.0.0:443             0.0.0.0:*               LISTEN      1234/nginx: master
而没有出现 :::80 或 :::443(或者 tcp6),就证明 Nginx 根本没有接入 IPv6 流量。
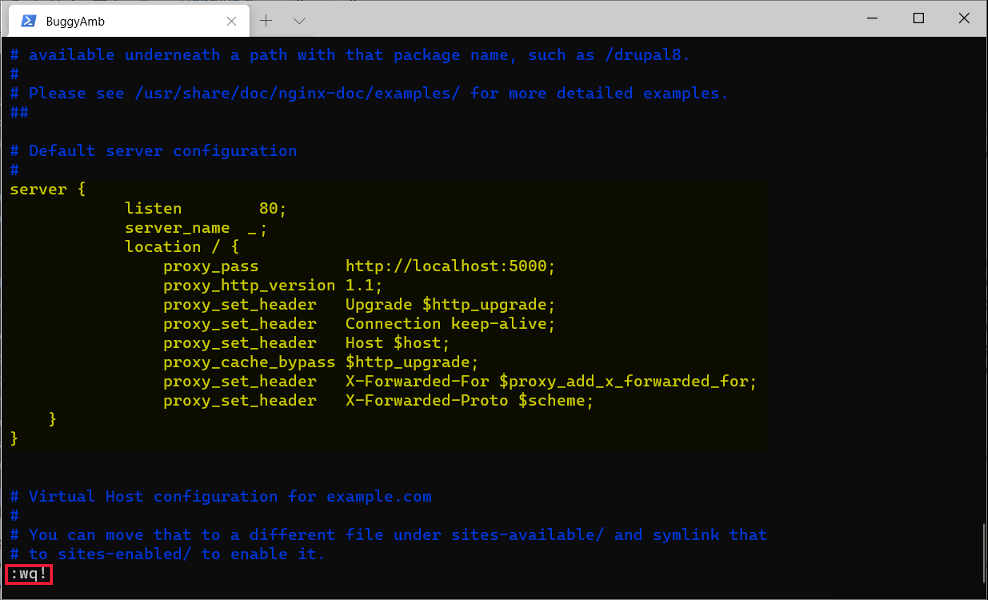
正确的做法是为每个站点配置显式的 IPv6 监听:
server {
    listen 80;
    listen [::]:80;
    listen 443 ssl http2;
    listen [::]:443 ssl http2;
    server_name example.com www.example.com;
    ...
}
修改后执行 nginx -t 测试并重载服务,再次用 netstat -tlpn 查看,确保能看到 :::80 和 :::443 处于 LISTEN 状态。
坑二:多虚拟主机下的 ipv6only 参数冲突与端口绑定报错
配置 Nginx IPv6 监听时,另一个常见坑点是 ipv6only 参数引发的冲突。
Linux 内核有一个控制网络栈行为的参数 net.ipv6.bindv6only,大多数发行版默认将其设为 0。当该参数为 0 时,如果程序绑定了 [::]:80,在默认情况下会同时隐式接管 IPv4 的 0.0.0.0:80。
假设你的服务器上有多个虚拟主机配置。如果第一个站点的配置写了:
server {
    listen 80;
    listen [::]:80;
    server_name site1.com;
}
而第二个站点你也照猫画虎写上:
server {
    listen 80;
    listen [::]:80;
    server_name site2.com;
}
有时候在特定旧版本 Nginx 或特定系统环境下执行 nginx -t 会直接报错:
nginx: [emerg] bind() to [::]:80 failed (98: Address already in use)有的同学搜到网上解答,看到有人建议在监听指令后加上 ipv6only=on:
listen [::]:80 ipv6only=on;结果随手给每一个配置块里的 [::]:80 都加上了这个参数,接着又会撞上另一个报错:
nginx: [emerg] duplicate listen options for [::]:80 in /etc/nginx/conf.d/site2.conf这是因为在 Nginx 的架构中,ipv6only=on/off 是一个套接字级别的参数,对于同一个 IP 与端口的组合,全局只能在第一次声明(或者在 default_server 块中)设置一次,后续的 server 块不能重复声明不同或相同的套接字选项。
如果你管理多个站点,最干净、最稳妥的做法是在默认虚拟主机(default server)里统一处理套接字绑定参数:
在默认站点(如 default.conf)中定义:
server {
    listen 80 default_server;
    listen [::]:80 default_server ipv6only=on;
    listen 443 ssl http2 default_server;
    listen [::]:443 ssl http2 default_server ipv6only=on;
    server_name _;
    return 444;
}
而在其他的业务站点(例如 example.com.conf)中,只需直接书写纯粹的监听指令,不要附加任何重复的套接字选项:
server {
    listen 80;
    listen [::]:80;
    listen 443 ssl http2;
    listen [::]:443 ssl http2;
    server_name example.com www.example.com;
    ...
}
这样既能确保所有 IPv4 与 IPv6 流量分流清晰,又避免了多站点重载时的套接字冲突。
坑三:Linux 防火墙与云厂商安全组的 IPv6 规则缺失
配完 Nginx 之后,千万别以为流量就能顺利进来了。网络层面上还有两堵墙:操作系统本地防火墙和云服务器外部安全组。
很多站长配置服务器安全策略时,习惯在命令行运行类似这样的指令:
iptables -A INPUT -p tcp --dport 80 -j ACCEPT
iptables -A INPUT -p tcp --dport 443 -j ACCEPT
iptables -P INPUT DROP注意,iptables 命令仅仅作用于 IPv4 数据包协议栈。
对于 IPv6 数据包,Linux 内核走的是一套完全独立的过滤工具:ip6tables(或者在较新系统中使用 nftables)。
很多人在部署新机器时,运行了某个现成的安全脚本,脚本把 iptables 规则配得严丝合缝,但根本没管 ip6tables;或者某些系统的默认策略对 ip6tables 设定为全部丢弃(DROP)。
这就造成了致命的不对称现象:IPv4 的 80 和 443 端口畅通无阻,而任何发往 IPv6 对应端口的握手包,在抵达操作系统网络层的第一时间就被防火墙静默丢弃了。爬虫发出 SYN 包后,得不到任何回应,只能一直干等直到超时。
检查本地 IPv6 防火墙状态:
ip6tables -L -n -v如果发现没有针对 80 和 443 的放行规则,需要显式添加:
ip6tables -A INPUT -p tcp --dport 80 -j ACCEPT
ip6tables -A INPUT -p tcp --dport 443 -j ACCEPT
如果使用 UFW,确认配置文件 /etc/default/ufw 中的 IPV6=yes 是否开启,并重新加载规则。
除了服务器本地操作系统,还有云厂商(如阿里云、腾讯云、华为云、AWS)控制台的安全组。很多云厂商的安全组是 IPv4 与 IPv6 规则分开管理的。你在安全组里放行了 0.0.0.0/0 的 80 和 443 端口,并不代表 IPv6 自动放行。务必在云控制台核对是否有针对 ::/0 的入方向 80 与 443 允许规则。
坑四:误封 ICMPv6 导致的 PMTUD 黑洞
这是导致爬虫偶发卡死、抓取大页面必超时的深水区大坑。
不少运维人员遵循旧习惯,喜欢在防火墙上把“所有 ping 包都禁掉”,以为这样能提升服务器隐蔽性。在 IPv4 时代,封禁 ICMP 虽然不规范,但通常不会导致网页彻底打不开,因为中间路由器如果遇到大于 MTU(最大传输单元)的数据包,可以直接进行分片(IP Fragmentation)。
然而在 IPv6 的技术规范中,设计发生了根本性的改变:网络中间路由器绝对不允许对 IPv6 数据包进行分片。分片工作必须且只能由数据发送端(你的源站服务器)自行完成。
这就依赖一个核心机制:路径最大传输单元发现(Path MTU Discovery,简称 PMTUD)。
当你的服务器向爬虫发送一段网页 HTML 时,如果数据包的大小(例如标准的以太网 1500 字节)超过了中间某个网络链路的 MTU(比如某些跨国骨干网、隧道或 VPN 链路只有 1280 或 1420 字节),中间路由器会把该数据包直接丢弃,同时向你的服务器回传一个 ICMPv6 报文,类型为 Type 2(Packet Too Big),告诉你的服务器:“包太大了,请把单个包体积缩小到 1420 字节再发”。
如果你在 ip6tables 里图省事,把所有 ICMPv6 流量全给拦了:
# 极其危险的操作:
ip6tables -A INPUT -p ipv6-icmp -j DROP
你的服务器就永远收不到这个“Packet Too Big”通知。
于是灾难发生了:
- 爬虫和服务器建立 TCP 三次握手成功(因为 SYN/ACK 包体很小,几十个字节,可以通过任何 MTU 链路)。
- 爬虫发起
GET /article-detail.html请求,请求头也很小,顺利抵达服务器。 - 服务器生成了 50KB 的文章内容,通过 TCP 分批发出。一旦发出的数据包超过 1280 字节,中间链路丢弃该包。
- 服务器迟迟收不到爬虫的 ACK 确认,便开始盲目重传原样大小的数据包;而中间路由器再次丢弃。
- 爬虫那端卡在接收阶段,一连几十秒等不到后续数据,最终超时断开连接,记录一次抓取失败。
在技术排查中,这种现象被称为“PMTUD 黑洞”。对于爬虫来说,短小的首页可能偶尔能抓取成功,而正文较长的深层文章页面几乎次次超时。
修复方法很简单:绝不能盲目拦截 ICMPv6。ICMPv6 是 IPv6 正常通信的骨干协议,包括邻居发现(NDP)和 PMTUD 都依赖它。
如果你的防火墙有严格过滤策略,至少必须放行以下关键类型:
# 放行已建立连接相关流量
ip6tables -A INPUT -m conntrack --ctstate ESTABLISHED,RELATED -j ACCEPT

# 核心:必须放行 Packet Too Big 报文(Type 2)
ip6tables -A INPUT -p ipv6-icmp --icmpv6-type packet-too-big -j ACCEPT

# 放行回显请求(允许 ping6,便于诊断)
ip6tables -A INPUT -p ipv6-icmp --icmpv6-type echo-request -j ACCEPT

# 放行邻居发现协议(NDP,局域网寻址必需)
ip6tables -A INPUT -p ipv6-icmp --icmpv6-type neighbor-solicitation -j ACCEPT
ip6tables -A INPUT -p ipv6-icmp --icmpv6-type neighbor-advertisement -j ACCEPT
严密验证:模拟纯 IPv6 抓取与监控日志
完成上述四步修正后,不要依赖普通浏览器去验证。我们要像爬虫一样,强制走纯 IPv6 协议栈进行端到端测试。
1. 命令行模拟 IPv6 抓取
在另一台支持 IPv6 的外部机器上,运行带有 -6 参数的 curl 命令:
curl -6 -Iv https://example.com观察输出的连接详情:
*   Trying 2400:8901::f03c:92ff:...:443...
* Connected to example.com (2400:8901::f03c:92ff:...) port 443 (#0)
* ALPN: offers h2,http/1.1
* TLSv1.3 (OUT), TLS handshake, Client hello (1):
* TLSv1.3 (IN), TLS handshake, Server hello (2):
...
< HTTP/2 200
确认能够正常连接到指定的 IPv6 地址并顺利拿到 HTTP 200 状态码。
接着测试大页面正文的下载完整性:
curl -6 -s https://example.com/article-detail.html > /dev/null
echo $?
返回码为 0 且无卡顿,说明 PMTUD 通路通畅,大包传输正常。
2. 在 Nginx 访问日志中观测真实爬虫 IP
为了持续跟踪搜索引擎蜘蛛是否恢复正常,可以在 Nginx 的日志格式(log_format)中加入客户端真实 IP 和响应耗时字段:
log_format main_dualstack '$remote_addr [$time_local] "$request" '
                          '$status $body_bytes_sent "$http_referer" '
                          '"$http_user_agent" $request_time';
当 Googlebot 或百度蜘蛛来访时,我们可以筛选它们的 IPv6 记录:
tail -f /var/log/nginx/access.log | grep -E "Googlebot|Baiduspider"如果日志中出现的爬虫 IP 是以类似 2600:1900:(Googlebot 常用 IPv6 段)或国内运营商 IPv6 段开头的地址,并且 HTTP 状态码为 200,请求耗时通常在 0.05 秒以内,就说明双栈改造已经彻底跑稳。
双栈网络确实是未来的大趋势,但在基础网络与安全组没有彻底调通之前,仓促上线 AAAA 记录很容易将搜索引擎蜘蛛拖入黑洞。排查网络故障时,多从爬虫与浏览器的机制差异入手,往往能少走很多弯路。
文章标题:网站配了 IPv6 搜索收录却断崖暴跌?排查 AAAA 记录黑洞、Nginx 漏配监听与爬虫超时我踩过的几个坑
文章链接:https://llbbs.cn/jishujaocheng/242.html
本站文章均为原创,未经授权请勿用于任何商业用途

评论一下?